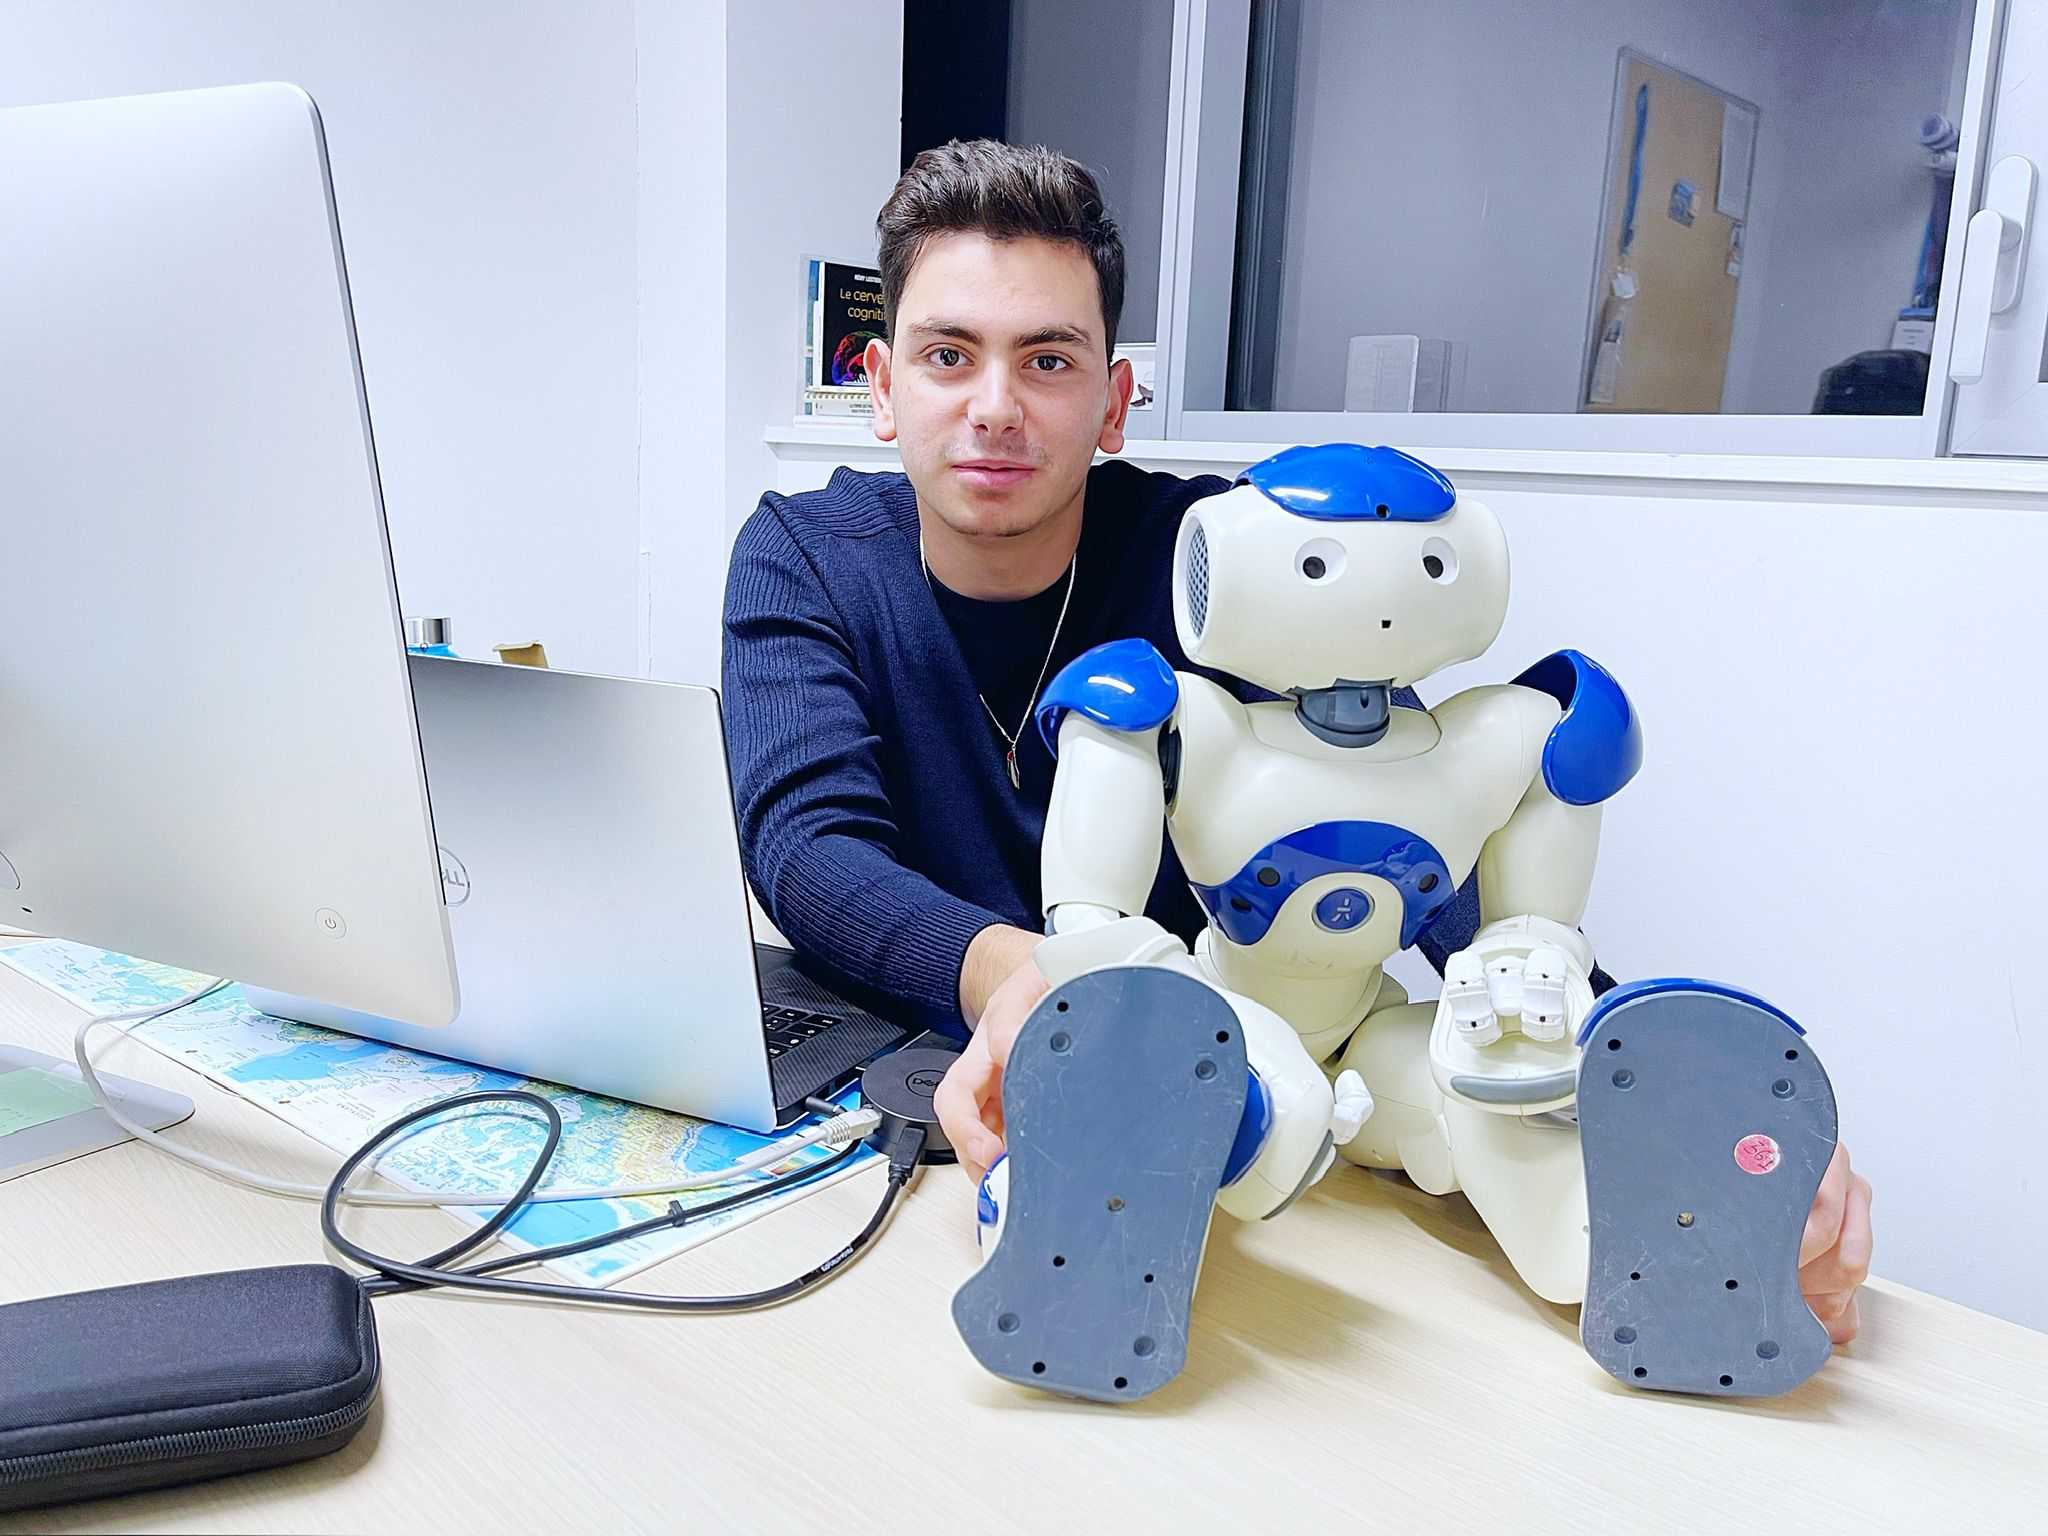
Pendant mon année d’alternance dans l’équipe-projet Mnemosyne de l’INRIA Bordeaux, sous l’encadrement de Xavier Hinaut, j’ai travaillé sur LingoRob, une plateforme de science participative qui collecte des données linguistiques multilingues pour entraîner des modèles neuronaux destinés à l’interaction humain-robot.
La plateforme recueille auprès des contributeurs trois types de données sur une même phrase : sa forme écrite, un enregistrement audio et une représentation sémantique structurée (prédicats, étiquetage des rôles sémantiques). Les corpus obtenus servent à entraîner des réseaux de neurones récurrents fondés sur le paradigme du Reservoir Computing, la famille de modèles inspirés du cerveau étudiée par l’équipe. Une fois entraînés, ces mêmes modèles assurent la compréhension du langage sur des robots humanoïdes comme le NAO ci-dessus.
Mon rôle portait sur l’ingénierie : assembler des briques prototypes en une seule application web Django/Python, intégrer la chaîne de traitement audio, concevoir les parcours des contributeurs pour écrire, lire et évaluer des phrases, et poser les bases de la démo en ligne, où les visiteurs peuvent tester le modèle sur leurs propres phrases, directement depuis le navigateur.
INRIA
Équipe Mnemosyne
Bordeaux
1 an
Alternance
2021–2022
RC
Reservoir Computing
RNN inspirés du cerveau
FR / EN / DE
Multilingue
corpus interlingues
Ce que fait la plateforme
- Une collecte à trois facettes. Pour chaque consigne, la plateforme enregistre une phrase écrite, sa lecture audio et une annotation sémantique (prédicats et rôles), ce qui rend le corpus réutilisable par plusieurs chaînes de modélisation.
- Multilingue dès la conception. Le français, l’anglais, l’allemand et d’autres langues partagent les mêmes tâches, ce qui sert la recherche sur l’universalité du langage et la généralisation d’une langue à l’autre.
- Contrôle qualité par les pairs. Les contributeurs relisent mutuellement leurs productions et signalent les contenus qui ne correspondent pas à la tâche : le corpus reste propre sans tri manuel.
- Démo du modèle en ligne. Les modèles de Reservoir Computing entraînés sont accessibles depuis la même interface web : neurolinguistes et visiteurs peuvent y soumettre des phrases, sans code ni installation.
- Des consignes ancrées dans la robotique. De nombreuses tâches demandent au contributeur d’écrire ou de prononcer des commandes destinées à un robot humanoïde dans une scène simulée, ce qui inscrit les données linguistiques dans la boucle d’interaction humain-machine.
Technologies
Python Django HTML · CSS · JS Reservoir Computing Audio MFCC Étiquetage des rôles sémantiques
Contexte et travaux antérieurs
LingoRob s’appuie sur des travaux antérieurs de l’équipe : des années de recherche sur le Reservoir Computing appliqué au langage, et des collaborations plus anciennes avec l’Université de Hambourg sur la conception de l’expérience des contributeurs, le contrôle de la qualité audio et l’interprétation du langage naturel pour des bras robotiques simulés. Ces études préliminaires, menées dans le cadre de projets de licence à Hambourg, ont guidé la taxonomie des tâches de la plateforme, son approche de ludification (arc motivationnel, classements, évaluations en plusieurs étapes) et sa chaîne d’assurance qualité. Le travail d’ingénierie mené pendant cette alternance a réuni ces briques en une seule application Django déployable.
Crédits
- Ingénierie
- Ammar Kheder, ingénieur de recherche (alternance)
- Encadrement
- Xavier Hinaut, INRIA Bordeaux, équipe-projet Mnemosyne
- Laboratoire d’accueil
- INRIA Mnemosyne, Bordeaux
- Technologies
- Python, Django, technologies web, modèles de Reservoir Computing
- Études préalables de conception et de faisabilité
- Projets de licence à l’Université de Hambourg, réutilisés en citant leurs auteurs